YOLOv2 Full-Graph FPGA 가속기
이 글에서는 256×256 RGB 이미지에서 60개 상품 클래스를 검출하는 YOLOv2를 Nexys 4 DDR에서 실행한 과정을 설명합니다. 정수 양자화부터 DDR 데이터 배치, descriptor 기반 제어, packed MAC, 두 detection head의 출력과 검증까지 연결했습니다. 최종 bitstream으로 229장을 평가한 결과와 함께, 각 단계에서 익히고 적용한 내용을 정리했습니다.
프로젝트 개요
Python host가 입력 이미지와 양자화 weight를 DDR에 적재하고 시작 레지스터를 설정하면, FPGA의 descriptor scheduler가 22개 처리 단계를 순서대로 실행한다. 144개 packed MAC lane이 convolution을 계산하고, 전용 경로가 Pool·Route·Upsample을 처리한다. 마지막 CONV14와 CONV20 detection head는 DDR의 서로 다른 주소에 보존된다. Host는 두 tensor를 읽어 같은 decode와 NMS를 적용한 뒤 detector mAP를 계산한다. 중간 feature와 weight는 8-bit로 저장하고, 곱셈의 합은 32-bit로 누적한 뒤 layer별 requantization을 거쳐 다시 8-bit로 저장한다.
- 대상 보드
- Nexys 4 DDR · xc7a100tcsg324-1
- 클록
- 100MHz
- 정수 경로
- INT8 저장 · INT32 누산 · requantization
- 담당 범위
- 양자화 · RTL 통합/최적화 · 보드 검증 · 패키징
경진대회 과제와 시스템 구성
객체 검출은 입력 이미지를 읽어 최종 상자를 그리는 하나의 함수처럼 보이지만, 하드웨어에서는 여러 시스템으로 나뉜다. 학습된 모델을 정수로 바꾸는 software reference, 대용량 tensor를 저장하는 DDR, layer를 순서대로 실행하는 RTL, 보드에 데이터를 넣고 결과를 회수하는 host, raw detection tensor를 실제 상자로 바꾸는 후처리가 모두 맞아야 한다. 이 프로젝트에서 FPGA가 맡는 범위는 입력 이후부터 CONV14·CONV20 두 head를 만드는 신경망 연산 그래프까지다. 이미지 전처리, bitstream program, DDR preload·readback, decode·NMS·mAP 평가는 host가 담당한다.
이 프로젝트에서 full graph는 Conv·Pool·Route·Upsample을 거쳐 CONV14·CONV20 두 detection head를 만드는 연산 전체를 가리킨다. FPGA 내부 scheduler가 이 순서를 진행하고, host는 두 출력을 decode와 NMS에 넣어 검출 결과를 평가한다.
객체 검출과 FPGA 가속
객체 검출은 물체의 위치를 나타내는 경계 상자와 클래스 점수를 함께 계산하는 작업이다. 이번 과제의 YOLOv2 모델은 단계적으로 특징을 추출하고 서로 다른 해상도의 feature map을 결합한 뒤, 8×8과 16×16 두 detection head에서 후보를 만든다. Host의 decode와 NMS는 이 출력을 상자로 변환하고 겹치는 후보를 정리한다.
FPGA에서는 많은 곱셈을 병렬화할 수 있지만, 연산기 수만 늘린다고 전체 모델이 자동으로 빨라지지는 않는다. 매 layer의 입력과 weight를 DDR에서 읽고, 중간 feature map을 정해진 주소에 저장하며, Route가 과거 결과를 다시 읽을 수 있도록 관리해야 한다. 정수 scale이나 주소가 한 layer에서만 어긋나도 뒤의 모든 출력이 달라진다. 그래서 이 프로젝트는 MAC 배열뿐 아니라 메모리 배치, layer 제어, 정수 후처리, 보드 readback을 하나의 시스템으로 다룬다.
| 용어 | 이 프로젝트에서의 의미 |
|---|---|
| Feature map | 각 convolution이 만든 중간 특징값 배열이며 DDR과 내부 buffer에 저장된다. |
| Weight | 학습으로 얻은 convolution 계수이며 INT8 형식으로 FPGA에 공급된다. |
| Descriptor | 연산 종류, tensor 크기, DDR 주소, scale을 한 단계씩 지정하는 제어 정보이다. |
| Detection head | 경계 상자, 물체 존재 확률, 클래스 점수를 담는 최종 tensor를 만든다. |
| mAP | 여러 클래스의 검출 정확도를 한 값으로 요약한 지표이며 단순 tensor 일치율과 다르다. |
설계 대상
이번 과제의 모델에는 convolution, 서로 다른 해상도의 feature map을 연결하는 Route, 해상도를 두 배로 만드는 Upsample과 두 detection head가 있다. 이 연산들을 연결하려면 DDR 주소, layer별 scale, head readback 형식을 함께 맞춰야 한다. 최종 그래프는 22개 descriptor로 구성했고, 초반의 특징 추출과 후반의 분기·결합을 순서대로 실행하도록 했다.
INT8 scale
대표 이미지 32장으로 activation 범위를 관찰하고, 후보 scale은 detector mAP를 비교해 설정한다.
Layer 연결
descriptor, DDR workspace, requantization 규칙을 맞춰 각 출력이 다음 layer의 올바른 입력이 되도록 연결한다.
처리 병목
weight cache, BRAM 배치, DDR read/write, 두 head 저장 때문에 생기는 대기까지 포함해 전체 cycle을 계산한다.
229장 detector 평가
단일 이미지로 주소와 출력을 점검한 뒤 229장 전체를 같은 bitstream으로 실행하고 최종 검출 mAP를 계산한다.
Host–FPGA 데이터 경로
시스템은 준비와 평가를 담당하는 host, 대용량 tensor를 보관하는 DDR, 정수 네트워크를 실행하는 FPGA로 나뉜다. host는 원본 이미지를 256×256 RGB로 변환하고 입력과 weight를 JTAG-to-AXI 경로로 DDR에 적재한다. FPGA가 시작 신호를 받으면 scheduler는 descriptor ROM을 0번부터 21번까지 읽으며 연산 종류와 주소를 설정한다. 마지막 두 head가 저장되면 done 신호가 발생하고, host가 tensor를 읽어 decode, NMS, mAP 계산을 수행한다.
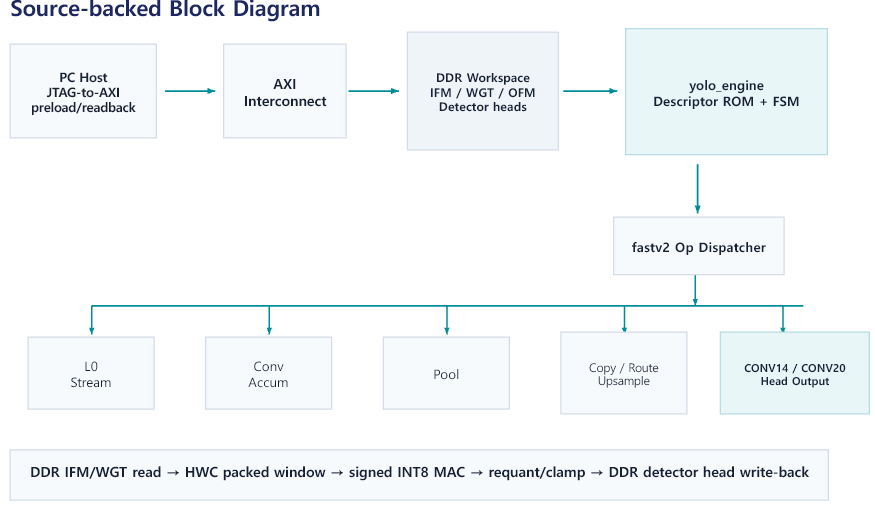
32-bit DDR word에는 HWC 순서의 INT8 channel 네 개가 들어간다. 이 packing은 버스 폭을 활용하는 동시에 소프트웨어와 RTL이 byte 순서와 signedness를 정확히 공유해야 한다는 제약을 만든다. 입력은 unsigned RGB이지만 detection head의 logit에는 음수가 필요하므로, backbone의 ReLU 출력과 head 출력을 같은 부호 규칙으로 처리할 수 없다. 이러한 차이는 descriptor와 requantization 설정에 명시된다.
최종 구현 기준
최종 사양은 descriptor ROM의 22개 항목과 공개 RTL의 NUM_MACS=144를 기준으로 정리했다. 정확도와 속도는
FINAL_RESULT.txt에 기록한 229장 실행 결과를 사용했다. RTL 설정, 보드 출력, Vivado 보고서를 같은 구현본으로
맞춰 확인했다.
| 항목 | 최종 기준 | 근거가 답하는 질문 |
|---|---|---|
| 그래프 | 22개 RTL descriptor | 어떤 연산과 head가 실제 실행되는가 |
| MAC | 144 packed MAC lane | 최종 계산 배열의 구조가 무엇인가 |
| 성능 | 229장 평균 11.420687 FPS | 두 head를 포함한 compute cycle은 얼마인가 |
| 정확도 | 두 head detector mAP 78.60% | FPGA 출력이 실제 검출에 얼마나 유효한가 |
Packed MAC은 입력을 받아들인 한 cycle에 288개의 scalar product를 계산하는 구조이다. 그래프 전체를 실행할 때는 DDR 대기, descriptor 전환, Pool·Route·Upsample, 결과 저장에도 시간이 필요하다. 따라서 배열의 연산량과 전체 실행 시간을 나누어 살펴보고, 최종 bitstream의 평균 cycle 수로 처리 속도를 계산했다.
단일 연산 검증에서 detector 검증까지
개발 초반에는 보드에 명령을 보내고 DDR의 정해진 주소를 읽고 쓰는 bring-up을 먼저 진행했다. 그다음 convolution 경로와 layer scheduler를 연결하고, Pool·Route·Upsample을 추가해 full graph로 확장했다. 그래프가 끝까지 실행된 뒤에는 HWC/CHW 배열 순서, 4-byte packing, detection head stride와 signed scale을 맞추는 작업을 이어갔다. 마지막 단계에서는 중간 속도 실험에서 제외했던 CONV14 branch를 복구하고 CONV14·CONV20을 모두 후처리에 사용하는 최종 검증 경로를 고정했다.
| 개발 단계 | 확인한 문제 | 완료 기준 |
|---|---|---|
| 보드 bring-up | JTAG-to-AXI, control register, DDR 접근 | 지정 주소 preload·readback과 start/done 확인 |
| 연산 경로 | INT8 MAC, bias, requantization, clamp | Software layer 출력과 RTL 출력 비교 |
| Full graph | Pool·Route·Upsample과 layer 전환 | Descriptor가 두 head까지 순서대로 실행 |
| 데이터 배치 | HWC packing, stride, branch 주소 | CONV14·CONV20이 올바른 위치에 저장 |
| 최종 signoff | Timing, 자원, 반복 실행, detector 정확도 | 229/229 PASS와 78.60% mAP |
두 head를 모두 보존하는 과정에서는 branch 계산과 DDR 저장, readback 비용이 늘어났다. 그 대신 두 출력을 함께 사용해 최종 detector mAP를 평가할 수 있었다. 이 과정을 거쳐 두 head 계산, timing closure, 229장 평가를 같은 bitstream에서 완료했다.
담당 범위
팀 프로젝트에서는 calibration과 scale 탐색을 포함한 양자화, 정수 데이터 형식과 RTL 경로의 통합·최적화, Nexys 4 DDR 보드의 반복 검증, 최종 실행 패키지 정리를 맡았다. 정수 모델에서 정한 규칙을 실제 메모리 배치와 연산 경로에 적용하고, 보드 결과를 다시 software reference와 비교하는 방식으로 작업했다.
Calibration과 mAP 기반 scale 탐색
32개 대표 이미지와 detector mAP를 기준으로 layer별 scale 조건을 설정한다.
정수 데이터 형식과 RTL 경로 연결
INT8 저장, INT32 누산, requantization 규칙을 descriptor와 DDR 배치에 적용한다.
Full graph 병목과 routing 위험 조정
두 head 검증과 timing closure를 만족하는 구조를 최종 구현 기준으로 사용한다.
단일 이미지·229장 평가
보드 실행, readback, detector 후처리, 제출 패키지를 같은 bitstream 기준으로 구성한다.
최종 결과
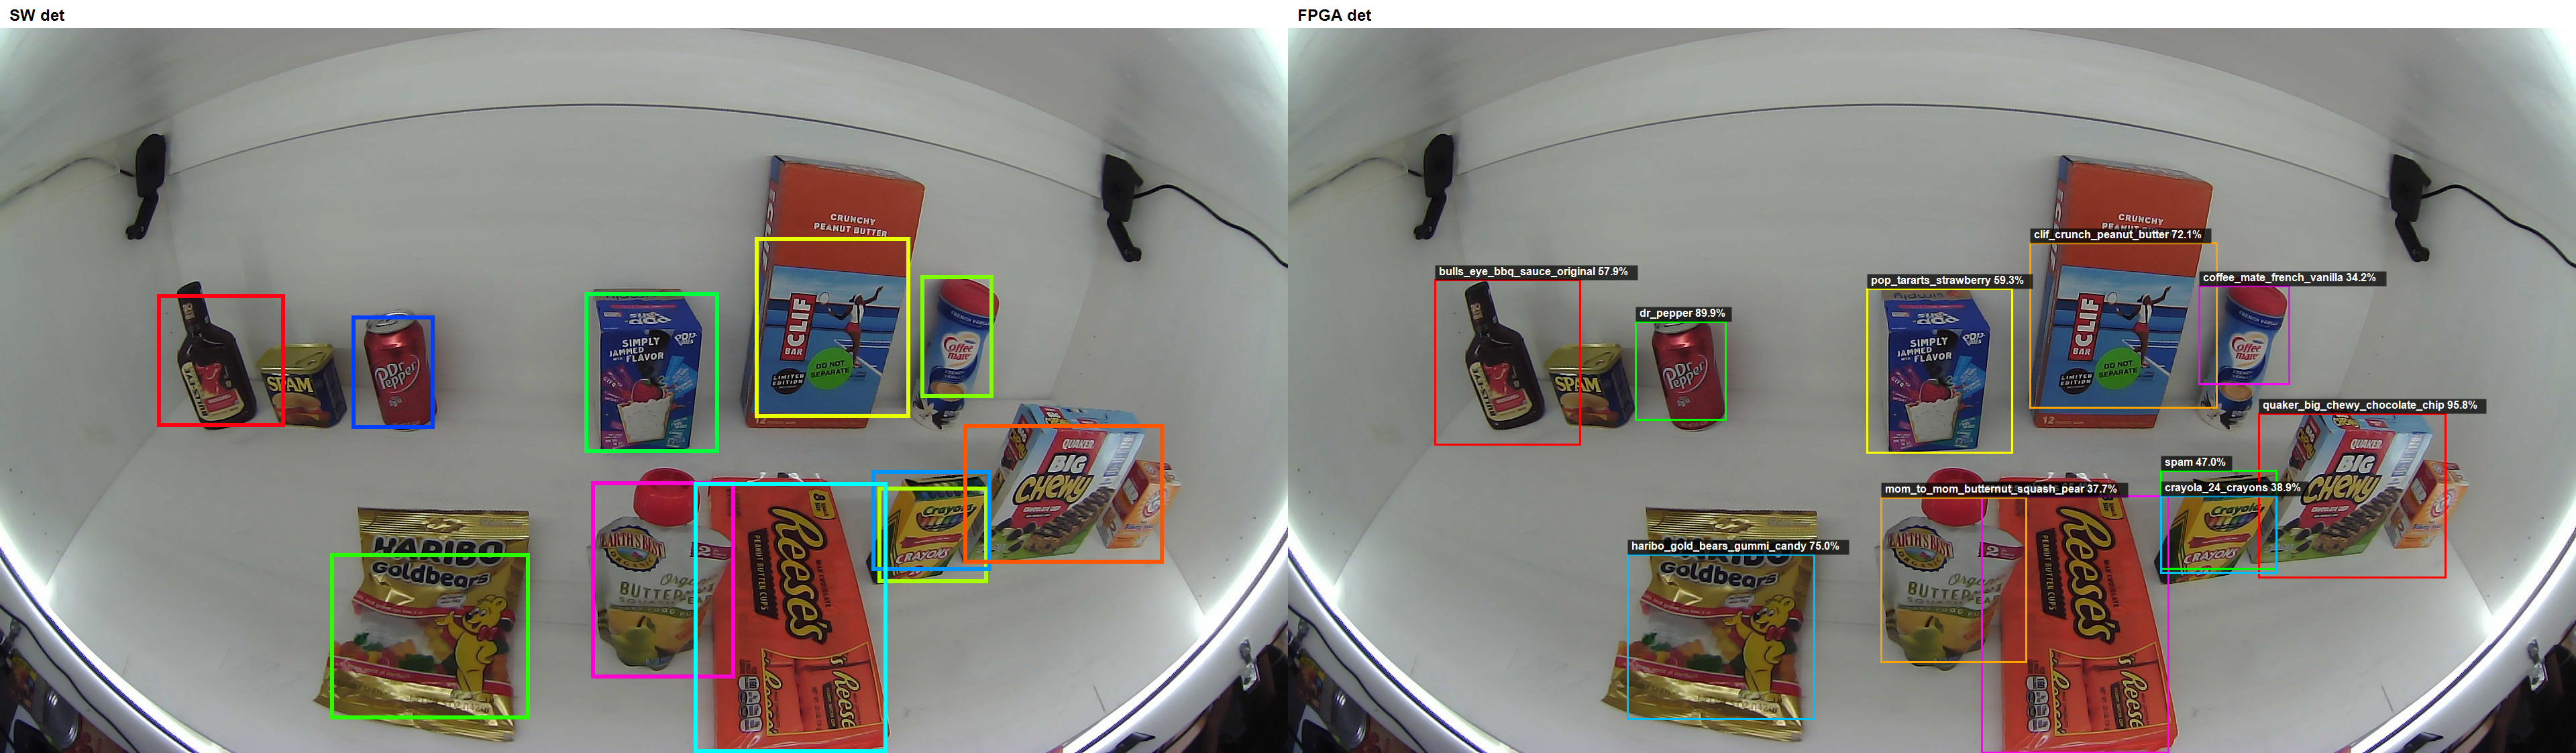
229장 모두에서 FPGA 실행과 두 head readback이 완료된다. 평균 8,756,040 cycles, 87.560404ms로 계산한 11.420687 FPS는 FPGA cycle counter 기준이며 JTAG 전송, Python 전처리와 후처리는 포함하지 않는다. INT8 software reference는 83.60% mAP, FPGA detector는 78.60% mAP이다.
최종 자원 사용률은 LUT 71.63%, FF 36.28%, BRAM 84.81%, DSP 85.42%이다. 100MHz에서 setup WNS +0.111ns, hold WHS +0.017ns로 timing을 만족했다. BRAM과 DSP 사용률이 모두 80%를 넘은 상태에서는 연산기나 buffer를 늘릴 때 배치·배선 부담도 함께 커진다. 전체 그래프를 구현하면서 계산 병렬도, 메모리 용량, timing을 함께 살펴봐야 하는 이유를 확인했다.