1. YOLOv2 정수 양자화
이 글에서는 YOLOv2의 실수 연산을 FPGA에서 사용할 정수 규칙으로 바꾼 과정을 설명합니다. Feature map과 weight는 8-bit로 저장하고, convolution 결과는 32-bit로 누적한 뒤 layer별 multiplier와 shift로 다시 8-bit 범위에 맞췄습니다. 32개 대표 이미지에서 값의 분포를 살펴보고, 11개 convolution의 계수를 조정하며 두 detection head의 detector mAP를 비교한 흐름을 정리했습니다.
Calibration 구성
Calibration 표본은 고정 seed 20260213으로 중복 없이 선택한 32장이다. 가까운 장면 16장과 먼 장면 16장을 같은 수로 포함해 16×16 head와 8×8 head가 다루는 물체 크기를 함께 반영했다. Scale은 channel별이 아니라 convolution layer별로 적용했다. 표본 목록과 seed를 고정한 이유는 multiplier 후보를 바꿀 때 입력 이미지까지 달라져 결과 해석이 섞이는 일을 막기 위해서다.
- 이미지
- 32장 · close 16 + long 16
- Seed
- 20260213
- Scale 단위
- Convolution layer별
- 평가 기준
- 두 head detector mAP
실수 값을 8-bit 정수로 바꾸는 원리
양자화는 연속적인 실수 범위를 제한된 정수 칸에 대응시키는 과정이다. 예를 들어 어떤 layer의 activation이 0부터 4까지 분포한다면, 이 범위를 0부터 255까지의 unsigned 8-bit 값에 대응시킬 수 있다. 값 하나가 어느 정수 칸에 들어가는지는 scale이 결정하며, 나중에 정수 곱셈 결과를 다음 layer의 scale로 바꾸려면 multiplier와 shift가 필요하다.
표현 범위를 너무 넓게 잡으면 대부분의 값이 몇 개 정수에 몰려 작은 차이가 사라진다. 반대로 범위를 너무 좁게 잡으면 큰 값이 −128~127 또는 0~255의 경계에서 잘리는 saturation이 늘어난다. 드물게 나타나는 극단값을 모두 보존할지, 일부를 clipping하고 자주 나타나는 값의 해상도를 높일지가 calibration의 핵심 절충이다. 단순한 최대 절댓값만으로 scale을 정하지 않고 최종 검출 정확도를 함께 본 이유가 여기에 있다.
| 단계 | 질문 | 확인 방법 |
|---|---|---|
| 범위 관찰 | 각 layer의 값이 주로 어디에 분포하는가 | Calibration 32장의 activation과 weight 통계 |
| Scale 후보 | 정수 칸을 어느 범위에 배분할 것인가 | Multiplier 후보와 clipping 범위 생성 |
| 오차 위치 | 어느 layer부터 software 정수 결과가 달라지는가 | Layer tensor와 mismatch 비율 비교 |
| 최종 판단 | 차이가 실제 검출 결과에 얼마나 영향을 주는가 | 두 detection head의 decode·NMS·mAP 평가 |
Calibration과 scale 탐색
calibration 이미지를 정수 모델에 통과시키며 layer별 activation과 weight 분포를 수집한다. 극단값 보존 범위와 saturation 범위는 정수 표현의 해상도에 영향을 준다. 분포는 scale 후보의 근거이고, detector mAP는 후보를 평가하는 기준이다. 가까운 장면과 먼 장면을 절반씩 포함한 것은 16×16 head와 8×8 head가 서로 다른 물체 크기에 반응하므로, 한쪽 장면만으로 범위를 정할 때 생기는 편향을 줄이기 위한 구성이다.
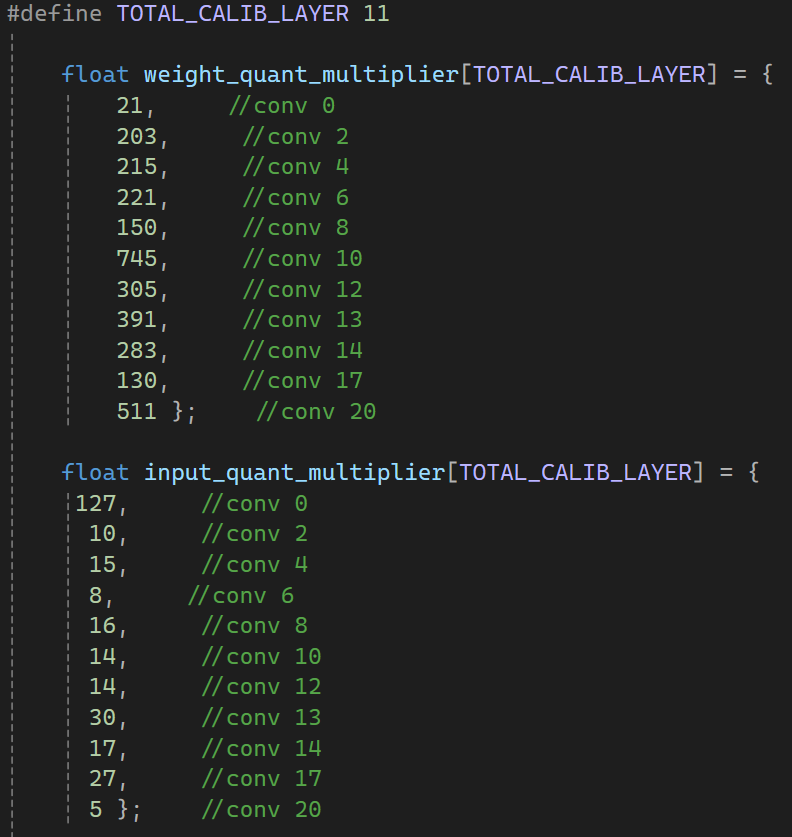
multipliers_83pct.txt와 같은 값이다.
| Graph layer | Calibration index | Input multiplier | Weight multiplier |
|---|---|---|---|
| CONV00 | 0 | 127 | 21 |
| CONV02 | 1 | 10 | 203 |
| CONV04 | 2 | 15 | 215 |
| CONV06 | 3 | 8 | 221 |
| CONV08 | 4 | 16 | 150 |
| CONV10 | 5 | 14 | 745 |
| CONV12 | 6 | 14 | 305 |
| CONV13 | 7 | 30 | 391 |
| CONV14 · 8×8 head | 8 | 17 | 283 |
| CONV17 · branch | 9 | 27 | 130 |
| CONV20 · 16×16 head | 10 | 5 | 511 |
mAP를 이용한 후보 탐색
실험 스크립트는 layer별 multiplier 후보를 파일로 저장하고, 환경 변수
AIX_QUANT_MULTIPLIER_FILE을 통해 정수 software 실행에
적용한다. 후보를 실행할 때마다 detector mAP를 계산해 현재 값과 비교하고,
이미 시도한 조합이나 악화 경향을 기록한다. 탐색 순서는 이전 결과를 이용해
다음 layer 후보를 정하도록 구성되어 있다. 따라서 최종 scale은 분포 그림을
보고 한 번에 정한 값이 아니라, 재현 가능한 calibration 표본과
검출 결과를 반복 비교해 얻은 값이다.
중간 tensor는 hardware와 software가 처음 달라지는 지점을 찾는 데 사용하고, detector mAP는 scale 후보를 선택하는 데 사용했다. Tensor의 평균 오차가 작아도 confidence나 class 순위가 바뀌면 최종 검출 결과가 달라질 수 있기 때문이다. 이 때문에 중간 값의 비교와 최종 검출 평가를 함께 진행했다.
정수 연산 데이터 경로
feature map과 weight는 8-bit로 저장하고, 여러 곱셈 결과가 더해지는 convolution accumulator는 32-bit를 사용한다. layer 출력은 bias와 활성화 뒤 고정소수점 multiplier와 shift를 거쳐 8-bit 범위로 변환된다. INT8 두 값을 곱한 결과는 그보다 넓으며, 3×3 kernel과 여러 입력 channel의 결과가 계속 더해지므로 저장 비트폭과 누산 비트폭을 동일하게 둘 수 없다. 32-bit 누산기는 중간 합의 overflow 여유를 확보한다.
ReLU 뒤 unsigned 8-bit
ReLU를 통과해 음수가 사라지는 backbone layer는 0~255 범위를 사용해 양수 해상도를 확보한다.
Signed 8-bit 출력
box와 class logit의 음수 값을 보존하기 위해 ReLU를 우회하고 −128~127 범위를 사용한다. 음수를 0으로 만들면 decode 이전에 정보가 손실된다.
Requantization
INT32 누산 결과는 layer별 multiplier, round offset, 오른쪽 shift, signed·unsigned clamp를 거쳐 8-bit feature map으로 변환된다. 이 규칙은 DDR 저장 형식과 다음 layer 입력 형식을 유지한다.
Requantization은 단순히 상위 비트를 버리는 과정이 아니다. 현재 layer의 입력 scale과 weight scale이 곱해진 누산값을 다음 activation scale에 맞춰야 한다. 실수 비율을 회로에서 직접 곱하지 않도록 정수 multiplier와 2의 거듭제곱 shift로 근사하고, 필요한 경우 반올림 offset을 더한다. 마지막 clamp는 결과가 8-bit 범위를 벗어났을 때 최대값 또는 최소값으로 제한한다.
CONV00 requantization 예시
최종 계수는 mul=1,006,507,
shift=28, round=0이다.
18,432×1,006,507을 28-bit 오른쪽 shift하면 69가 되고,
unsigned clamp 뒤에도 69가 유지된다.
Layer별 rounding
CONV00은 round offset이 0이라 양수는 shift 과정에서 잘린다. signed 음수는 절댓값을 shift한 뒤 부호를 복원하고 최종 범위로 제한한다.
공개 RTL에서는 bias, 선택적 ReLU, multiplier, shift, rounding, signed·unsigned clamp가 pipeline으로 이어지는 모습을 볼 수 있다. Software의 정수 규칙을 각 단계의 비트폭과 연산 순서에 대응시키며 후처리 경로를 확인했다.
정수 software reference 정확도
최종 정수 계수를 적용한 software reference의 detector mAP는 83.60%이다. 이 결과를 정수 연산의 기준선으로 두고, FPGA에서 실행한 78.60%와 비교했다.

Software 정수 기준선 83.60%와 FPGA 결과 78.60% 사이에는 약 5.00%p 차이가 남았다. 이 차이를 살펴보기 위한 비교 항목은 byte packing, signedness, descriptor 주소, head별 scale, requantization 순서와 host 후처리이다. 양자화 규칙을 정한 뒤에도 보드의 데이터 흐름 전체에서 같은 규칙이 유지되는지 확인해야 한다. 다음 글에서는 이 규칙을 22개 descriptor, DDR workspace, 144-lane MAC에 연결한 구조를 다룬다.