2. YOLOv2 Full-Graph FPGA 구조
이 글에서는 YOLOv2의 각 layer를 하나의 FPGA 실행 경로로 연결한 구조를 설명합니다. DDR을 공용 workspace로 사용하고, 22개 descriptor로 연산 종류와 데이터 크기·주소를 지정했습니다. 144-lane packed MAC의 계산뿐 아니라 weight 공급, feature 재사용, requantization과 write-back까지 함께 살펴보며 전체 처리 흐름을 정리했습니다.
최종 구현 사양
Nexys 4 DDR의 Artix-7은 100MHz로 동작하며, JTAG-to-AXI가 host의 검증 스크립트와 DDR을 연결한다. FPGA 내부에는 22단계 descriptor ROM, graph scheduler, op dispatcher, 144개 packed MAC lane, weight cache, feature·accumulator buffer, requantization과 write-back 경로가 있다. 입력과 weight는 실행 전에 DDR에 적재하고, 네트워크가 끝나면 CONV14와 CONV20 두 head를 다시 읽는다. Host는 layer마다 명령하지 않고 start와 done만 관리하며, 그래프 진행은 RTL scheduler가 담당한다.
- Device
- xc7a100tcsg324-1 · Artix-7
- DDR
- DDR2 DQ 16-bit · MIG AXI UI 64-bit
- Host
- JTAG-to-AXI 32-bit
- 출력
- 8×8×195 + 16×16×195
YOLOv2 그래프를 이루는 연산
Convolution은 작은 kernel을 이미지와 feature map 위로 이동시키며 특징을 추출한다. Pool은 공간 크기를 줄여 계산량을 낮추고 더 넓은 영역의 정보를 모은다. Route는 앞에서 계산한 feature map을 다시 가져와 현재 경로와 channel 방향으로 연결한다. Upsample은 값을 반복해 가로와 세로 해상도를 두 배로 만든다. 두 detection head는 이러한 특징으로부터 위치, 물체 존재 확률, 60개 클래스 점수를 출력한다.
연산 종류마다 메모리 접근 방식이 다르다. Convolution은 많은 weight와 입력 window를 반복 사용하므로 cache와 재사용 구조가 중요하다. Pool과 Upsample은 곱셈이 거의 없지만 큰 feature map을 읽고 쓰기 때문에 DDR traffic이 병목이 될 수 있다. Route는 오래된 feature map이 덮어쓰이지 않도록 주소를 보존해야 한다. 하나의 연산기만 최적화하지 않고 그래프 전체를 descriptor와 workspace로 관리한 이유가 여기에 있다.
Host–FPGA 역할
Host는 bitstream program, 입력 전처리, weight·input DDR preload, 시작 명령과 완료 polling을 담당한다. FPGA scheduler는 descriptor를 따라 22개 단계를 실행하고 두 detection head를 DDR에 기록한다. Host가 이 출력을 읽어 box decode, class score 계산과 NMS를 수행하면 최종 검출 결과가 나온다.
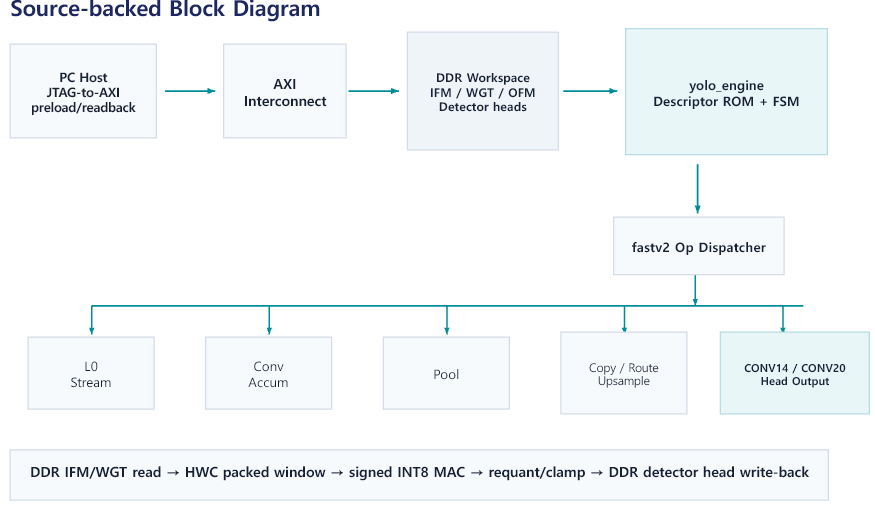
Host에서는 DDR의 지정 주소에 입력과 weight를 넣고, 실행 후 layer 출력이나 head를 읽어 software reference와 비교할 수 있다. JTAG-to-AXI를 이런 데이터 전달과 점검에 사용했다. 실행 시간도 host의 전체 검증 시간과 FPGA 내부 cycle counter로 측정한 계산 시간으로 나누어 기록했다.
한 프레임이 두 detection head가 되기까지
실행 준비 단계에서는 bitstream을 program하고, quantized weight와 256×256×3 입력을 정해진 DDR base address에 적재한다. Host가 control register의 start bit를 올리면 scheduler가 0번 descriptor를 읽고 첫 convolution을 시작한다. 이후 각 단계의 출력 저장과 완료 상태를 확인하며 다음 descriptor로 넘어간다. Layer 사이의 실행 순서는 FPGA 내부에서 관리한다.
| 실행 구간 | 읽는 데이터 | 수행하는 동작 | 남기는 결과 |
|---|---|---|---|
| Descriptor 0–9 | 입력/이전 OFM, 3×3 weight | Conv와 2×2 Pool 반복 | 8×8×256 backbone feature |
| Descriptor 10–13 | 깊어진 feature와 weight | Conv·stride-1 Pool·1×1/3×3 Conv | 8×8×512 feature |
| Descriptor 14–15 | 8×8×512 | 첫 1×1 detection convolution | CONV14 8×8×195 보존 |
| Descriptor 16–19 | Branch feature와 과거 skip feature | Copy·1×1 Conv·Upsample·Route | 16×16×384 fusion feature |
| Descriptor 20–21 | 16×16×384 | 두 번째 1×1 detection convolution | CONV20 16×16×195 보존 |
첫 head는 낮은 해상도에서 추출한 깊은 특징을 사용한다. 두 번째 head는 upsample한 feature와 앞쪽의 고해상도 feature를 Route로 결합한다. 최종 구현에서는 CONV14와 CONV20 출력을 모두 DDR에 보존해 두 해상도의 검출 결과를 함께 평가했다.
DDR workspace와 두 detection head
전역 workspace는 feature map 주소 구간을 재사용한다. Route가 다시 읽는 feature map과 두 detection head 출력은 별도 주소에 보존한다. 하나의 32-bit word에는 8-bit HWC 값 네 개가 저장된다. HWC는 같은 공간 좌표의 channel 값이 연속으로 놓이는 배열 순서를 뜻한다. Host가 쓰는 byte 순서와 RTL이 lane으로 꺼내는 순서가 다르면 값은 정상이어도 channel이 섞이므로 두 쪽의 packing 규칙을 동일하게 유지해야 한다.
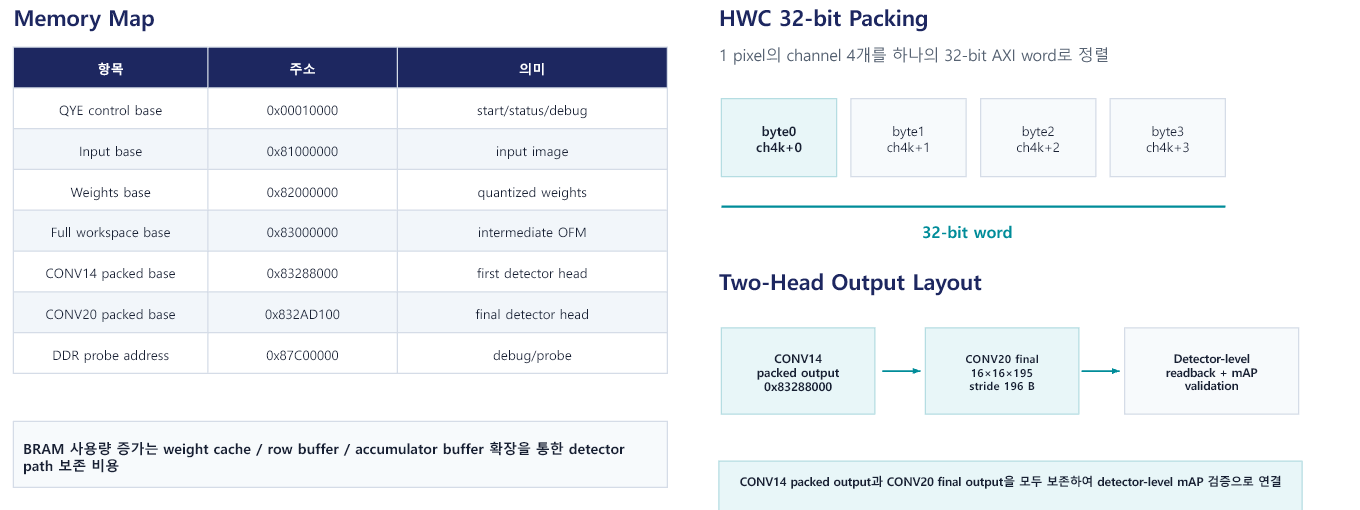
Route
분기 지점의 출력 주소를 descriptor에 보존하고, 이후 feature와 channel 방향으로 결합한다. 두 번째 head가 고해상도와 깊은 특징을 함께 사용하도록 하는 경로이다.
Upsample
8×8 feature의 각 값을 반복하는 nearest-neighbor 방식으로 16×16까지 확장한 뒤 앞 단계 feature와 Route한다.
22개 layer descriptor
descriptor ROM에는 각 단계의 연산 종류, 입력·출력 shape, DDR 주소, kernel·stride·activation·requantization 조건이 저장된다. scheduler는 같은 compute block을 재사용하며 descriptor에 따라 전체 그래프를 진행한다. 소프트웨어의 함수 호출 목록에 해당하는 정보를 하드웨어의 고정된 제어 표로 옮긴 구조라고 볼 수 있다.
| 구간 | Descriptor | 처리 내용 | 구간 출력 |
|---|---|---|---|
| Backbone 전반 | 0–9 | Conv 5회 + 2×2 Pool 5회 | 8×8×256 |
| Backbone 후반 | 10–13 | 3×3 Conv · stride-1 Pool · 1×1/3×3 Conv | 8×8×512 |
| Head 1 | 14–15 | 1×1 Conv와 detection output | 8×8×195 |
| Feature fusion | 16–19 | Route · 1×1 Conv · 2× Upsample · Route | 16×16×384 |
| Head 2 | 20–21 | 1×1 Conv와 detection output | 16×16×195 |
Descriptor 0–13은 입력 해상도를 줄이며 특징을 추출하는 backbone이다. 14번에서 8×8×195 첫 head를 계산하고 15번에서 그 결과를 보존한다. 16번에서는 분기에 사용할 feature를 복사한다. 이어 17번의 1×1 convolution, 18번의 upsample, 19번의 Route를 거쳐 16×16×384 feature를 만든다. 마지막으로 20번에서 16×16×195 두 번째 head를 계산하고 21번에서 출력을 보존한다. 이렇게 최종 RTL의 22개 descriptor가 전체 실행 순서를 구성한다.
144-lane packed MAC
144는 3×3 kernel과 16개 입력 channel을 한 묶음으로 처리하는
3×3×16 구조에서 나온다. packed-pair DSP 경로는
하나의 weight와 두 activation을 공유해 두 spatial dot product를
계산한다. 1×1 convolution에서는 필요한 lane group만 활성화해 같은
array를 재사용한다.
일반적인 MAC은 activation과 weight를 곱한 뒤 기존 합에 더한다. 3×3 convolution에서 입력 channel 16개를 한 tile로 처리하려면 한 출력 위치당 3×3×16, 즉 144개의 곱셈 항이 필요하다. Packed-pair 구조는 동일한 weight를 사용하는 인접한 두 공간 위치의 activation을 DSP 입력에 함께 배치해 두 dot product를 병렬로 만든다. 내부 reduction tree는 부분합을 23-bit 폭으로 모으고 외부에서는 32-bit accumulator로 channel tile의 합을 이어 간다.
데이터 경로 병목
| 지점 | 관찰한 문제 | 구조에 반영한 내용 |
|---|---|---|
| 초기 feature map | 같은 입력을 DDR에서 반복해 읽음 | Line/window reuse |
| Weight 공급 | MAC이 DDR 응답을 기다림 | Banked weight cache와 prefetch |
| Route/Upsample | 계산은 적지만 DDR traffic 발생 | 전용 copy 경로와 burst 처리 |
| 결과 저장 | AXI backpressure가 compute를 멈춤 | Valid/ready와 burst 경계 조정 |
| Requantization | 곱셈 경로가 timing을 압박 | Partial product와 pipeline register |
데이터 경로를 살펴보면 MAC 앞뒤에도 대기 구간이 있다. 입력 window와 weight가 준비되어야 계산을 시작할 수 있고, 출력 FIFO나 AXI write가 막히면 다음 계산도 대기한다. 초반 layer는 큰 feature map의 메모리 이동 비중이 높고, 후반 layer는 많은 channel의 누산과 weight 공급 부담이 크다. 이 차이를 반영해 line reuse, weight prefetch, burst 길이와 pipeline 위치를 함께 조정했다.
최종 timing 보고서의 critical route는 weight cache의 write data register에서 BRAM 입력으로 이어지는 배선 경로였다. 논리 단계 수뿐 아니라 BRAM의 배치와 fanout도 timing에 영향을 준다는 점을 확인했다. 최종 구현은 100MHz에서 WNS +0.111ns를 만족했고, 같은 bitstream으로 두 detection head readback과 229장 detector 검증을 진행했다.